Archivo de la etiqueta: Inteligencia Artificial

INTELIGENCIA ARTIFICIAL Y AVANCES EN FÍSICA EN EL CAMPO DE LAS ONDAS GRAVITACIONALES (I)

Giancarlo Elia Valori*

Imagen: geralt en Pixabay, https://pixabay.com/es/iísica-física-cuántica-partículas-6780710/

Como una rama importante de las ciencias naturales, la física estudia leyes y fenómenos fundamentales como la materia, la energía, la mecánica y el movimiento, proporcionando así una base teórica importante para que los seres humanos comprendan y exploren el mundo natural. Para ser precisos, la física modela la naturaleza matemáticamente.

Con el avance de la ciencia y de la tecnología y el rápido desarrollo de la Inteligencia Artificial, la física se enfrenta a nuevos desafíos y oportunidades. La aplicación de la IA está cambiando los métodos de investigación y la trayectoria de desarrollo de la física, ofreciendo así nuevas posibilidades de progreso e innovación.

La inteligencia artificial puede ayudar a los físicos a construir modelos más precisos y complejos y a analizar e interpretar experimentos y datos proporcionados por la observación. Debemos tener en cuenta algoritmos como el aprendizaje automático, del cual el aprendizaje profundo es una parte.

La diferencia radica en el hecho de que el aprendizaje profundo es más avanzado: un algoritmo de aprendizaje profundo no está condicionado por la experiencia del usuario. Solo para hacer un ejemplo, en el aprendizaje automático no profundo, para distinguir gatos y perros hay que decir «hazlo por orejas, pelo, etc…», mientras que en el aprendizaje profundo las características distintivas son extraídas por el propio código y, a menudo o siempre, ¡en realidad son patrones que los humanos nunca podríamos tener!

Lo hace de la siguiente manera: le das un conjunto de datos de entrenamiento y los resultados esperados. El algoritmo comienza a hacer pruebas sobre este reconocimiento hasta que alcanza un valor de precisión aceptable basado en lo que debería obtener mediante el uso de matemáticas iterativas (y obviamente existe la mano humana en la construcción del algoritmo). Cuando se haya «ajustado», puede usarlo en imágenes desconocidas de gatos y perros, no utilizadas para el aprendizaje, de modo que los clasifique al humano sin que el humano tenga que hacerlo él mismo. Teniendo en cuenta lo anterior, la Inteligencia Artificial puede descubrir patrones ocultos y correlaciones a partir de grandes cantidades de datos, ayudando así a los físicos a comprender y predecir fenómenos relacionados.

La inteligencia artificial se puede aplicar a la física teórica y a la investigación de la física computacional para mejorar la eficiencia y la precisión de los modelos y métodos computacionales. Por ejemplo, la Inteligencia Artificial puede ayudar a los físicos a desarrollar métodos de simulación numérica, ya que el aprendizaje automático no es solo para la clasificación, sino también para la predicción numérica, que es especialmente útil en el campo financiero, ya que es más eficiente para acelerar los experimentos y cálculos.

La IA también tiene amplias aplicaciones en los campos de la física cuántica y la computación cuántica. La física cuántica es una rama de la ciencia que estudia el comportamiento de las partículas microscópicas y las leyes de la mecánica cuántica, mientras que la computación cuántica es un campo emergente que utiliza las características de la mecánica cuántica para el procesamiento de la información y los cálculos. La inteligencia artificial puede ayudar a los físicos a diseñar sistemas y algoritmos cuánticos más complejos y promover el desarrollo y la aplicación de la informática.

La aplicación de la IA en experimentos de física de partículas y física de altas energías también es muy importante. La física de altas energías estudia la estructura y la interacción de las partículas microscópicas, mientras que la física de partículas estudia el origen y la evolución del universo. La IA puede ayudar a los físicos a analizar y procesar grandes cantidades de datos experimentales y descubrir posibles nuevas partículas y fenómenos físicos.

La tecnología puede mejorar la eficiencia de la investigación física y acelerar el proceso de investigación científica. La investigación física a menudo requiere grandes cantidades de datos experimentales y modelos computacionales complejos, y la IA puede agilizar el trabajo de los físicos para descubrir patrones ocultos y correlaciones en estos datos. La inteligencia artificial también puede proporcionar modelos físicos más precisos y detallados, ayudando a los físicos a resolver problemas científicos aún más complejos.

La investigación física tradicional a menudo se basa en teorías y experimentos existentes, mientras que la IA puede ayudar a los físicos a descubrir nuevos fenómenos y leyes físicas. Al sacar a la luz patrones y correlaciones a partir de grandes cantidades de datos, la Inteligencia Artificial estimula a los físicos a proponer nuevas hipótesis y teorías, promoviendo así el desarrollo y la innovación.

La aplicación de la IA explora campos y fenómenos desconocidos. Al analizar y extraer información de grandes cantidades de datos, la Inteligencia Artificial amplía el alcance y la profundidad de la investigación física.

El desarrollo de la IAl ofrece nuevas oportunidades para la integración de la física con otras disciplinas. Por ejemplo, la combinación de IAl y ciencias biológicas puede ayudar a los físicos a estudiar sistemas biológicos complejos y fenómenos relacionados. La combinación de inteligencia artificial y química puede ayudar a los físicos a estudiar la estructura molecular y las reacciones químicas.

Aunque la tecnología de IA tiene amplias perspectivas de aplicación en la investigación física, también tiene que enfrentar algunos desafíos, incluida la adquisición y el procesamiento de datos, ya que este es el principal problema, especialmente cuando se trata de nuevos problemas para los cuales las bases de datos son escasas; la creación y verificación del modelo físico; y la selección y optimización de algoritmos. En este sentido, hay que decir que el auge del aprendizaje profundo se ha debido principalmente al aumento de los datos disponibles gracias a Internet y al avance del hardware. Las redes que cualquiera usa pueden ejecutarse en sus computadoras portátiles, aunque lentamente, pero esto habría sido impensable en la década de 1990, cuando el aprendizaje profundo ya se pensaba de una manera muy vaga. No en vano hablamos de la «democratización del aprendizaje profundo».

El desarrollo futuro requiere cooperación e intercambios entre físicos y profesionales de la IA para resolver conjuntamente estos desafíos y aplicar mejor esta nueva tecnología a la investigación y las aplicaciones de la física.

Como tecnología emergente, la IA está revolucionando la física tradicional. Al aplicar la IA, los físicos pueden construir modelos más precisos y complejos, analizar y explicar experimentos de física y datos observacionales. La IA necesariamente acelera el proceso de investigación en física y promueve el desarrollo y la innovación de la llamada física tradicional.

La IA, sin embargo, todavía tiene que enfrentar algunos desafíos y problemas en la investigación física, que requieren más estudio y exploración. En el futuro, la tecnología de IA se utilizará aún más en la investigación y las aplicaciones físicas, proporcionando así más oportunidades y desafíos para el desarrollo y la innovación.

La tecnología de IA también se utiliza en la investigación de ondas gravitacionales, cuyo Premio Nobel de Física 2017 fue otorgado a Rainer Weiss (Alemania), Barry C. Barish (EE.UU.)

El 14 de septiembre de 2015, este grupo de científicos detectó la señal de onda gravitacional de un sistema de dos agujeros negros que se fusionaron por primera vez. En ese momento, desencadenó una revolución en la comunidad astrofísica: el grupo de investigación involucrado en el descubrimiento de las ondas gravitacionales fue incluido como candidato al Premio Nobel de Física desde entonces. Los dos agujeros negros se encuentran a unos 1.800 millones de años luz de la Tierra. Sus masas antes de la fusión eran equivalentes a 31 y 25 soles de tamaño, respectivamente. Después de la fusión, la masa total fue equivalente a 53 soles de tamaño. Tres soles fueron convertidos en energía y liberados en forma de ondas gravitacionales.

Durante algún tiempo, las ondas gravitacionales han atraído la atención y la curiosidad no solo de los científicos, sino también de los ciudadanos comunes. A pesar de ser una fuerza débil (un niño que levanta un juguete lo demuestra ampliamente), la interacción gravitacional siempre ha creado preguntas: pero ¿qué son las ondas gravitacionales?

Para decirlo simple y brevemente, este concepto de ondas gravitacionales proviene de la teoría de la relatividad general de Einstein. Todos sabemos que la teoría de la relatividad siempre discute la relación dialéctica entre el espacio-tiempo y la materia, y el punto de vista de las ondas gravitacionales es que la materia causa ondas y se dobla en el espacio-tiempo. La curva se propaga hacia afuera desde la fuente de radiación en forma de onda. Esta onda transmite energía como radiación gravitacional y la velocidad de las ondas gravitacionales es cercana a la de la luz. Un caso extremo es un agujero negro. Su supermasa provoca una distorsión del espacio-tiempo; La luz no puede escapar y se desliza en ella.

Debido a que nuestra comprensión básica de la física tradicional se basa en la teoría de la gravitación universal de Newton, se supone que todos los objetos tienen una atracción mutua. El tamaño de esta fuerza es proporcional a la masa de cada objeto. Einstein creía que esta teoría era superficial. La razón de lo que parece ser el efecto de la gravedad se debe a la distorsión del espacio y el tiempo. Por lo tanto, si la ley de gravitación universal de Newton es aproximada, ¿se está extraviando nuestro conocimiento actual basado en la física tradicional? La pregunta es incómoda. Por lo tanto, dejemos que los científicos estudien más a fondo quién tiene razón y quién está equivocado.

Dicho esto, sin embargo, la investigación científica cósmica actualmente utiliza cada vez más técnicas de IA, como la detección y el descubrimiento de las ondas gravitacionales antes mencionados. El mayor desafío en la captura de ondas gravitacionales es que la tasa de muestreo de los datos LIGO (Laser Interferometer Gravitational-Wave Observatory) es extremadamente alta, alcanzando una frecuencia superior a 16,000 veces por segundo, con decenas de miles de canales de muestreo. Por lo tanto, la cantidad de datos es extremadamente grande. Entonces se entiende que con el aprendizaje automático de IA, etc. y los métodos de vanguardia en el campo del procesamiento de datos, se puede mejorar la eficiencia de la investigación. (1. continuará)


* Copresidente del Consejo Asesor Honoris Causa. El Profesor Giancarlo Elia Valori es un eminente economista y empresario italiano. Posee prestigiosas distinciones académicas y órdenes nacionales. Ha dado conferencias sobre asuntos internacionales y economía en las principales universidades del mundo, como la Universidad de Pekín, la Universidad Hebrea de Jerusalén y la Universidad Yeshiva de Nueva York. Actualmente preside el «International World Group», es también presidente honorario de Huawei Italia, asesor económico del gigante chino HNA Group y miembro de la Junta de Ayan-Holding. En 1992 fue nombrado Oficial de la Legión de Honor de la República Francesa, con esta motivación: “Un hombre que puede ver a través de las fronteras para entender el mundo” y en 2002 recibió el título de “Honorable” de la Academia de Ciencias del Instituto de Francia.


Traducido al español por el Equipo de la SAEEG con expresa autorización del autor. Prohibida su reproducción.

©2023-saeeg®
 

INTELIGENCIA ARTIFICIAL Y AVANCES EN QUÍMICA (II)

Giancarlo Elia Valori*

Fuente: https://numerentur.org/markov-mdp/


Como se ha visto anteriormente, los tipos de representación química han desarrollado varios subtipos en los últimos años. Desafortunadamente, sin embargo, no hay una respuesta clara sobre qué representación es la más eficiente para un problema en particular. Por ejemplo, las representaciones matriciales son a menudo la primera opción para la predicción de atributos, pero, en los últimos años, los gráficos también han surgido como alternativas fuertes. También es importante tener en cuenta que podemos combinar varios tipos de representaciones dependiendo del problema.

Por lo tanto, ¿cómo (y cuáles) representaciones se pueden usar para explorar el espacio químico? Ya hemos dicho que las representaciones de cuerdas son adecuadas para el modelado generativo. Inicialmente, las representaciones gráficas no eran fáciles de modelar mediante el uso de modelos generativos, pero más recientemente su combinación con el Variational Autoencoder (VAE) las ha convertido en un factor muy atractivo.

En el aprendizaje automático, un autoencoder variacional es una arquitectura de red neuronal artificial introducida por Diederik P. Kingma y Max Welling. Es parte de las familias de modelos gráficos probabilísticos y métodos bayesianos variacionales (es decir, familia de métodos para la aproximación de integrales).

Los VAE han demostrado ser particularmente útiles ya que nos permiten tener una representación continua más legible por máquina. Un estudio utilizó VAE para demostrar que tanto las representaciones de cadenas como las de gráficos pueden codificarse y decodificarse en un espacio donde las moléculas ya no son discretas, sino que pueden decodificarse en vectores continuos con valores reales de representaciones de moléculas. La distancia euclidiana entre diferentes vectores corresponderá a la similitud química. Se agrega otro modelo entre el codificador y el decodificador para predecir el atributo que se alcanzará en cualquier punto del espacio.

Pero si bien generar moléculas per se es una tarea simple, podemos tomar cualquier modelo generativo y aplicarlo a la representación que deseamos, generar estructuras que sean químicamente válidas y muestren las propiedades que deseamos es un tema mucho más desafiante.

Los enfoques iniciales para lograr este objetivo implican modelos sobre conjuntos de datos existentes y su posterior uso para la transferencia al aprendizaje. El modelo se ajusta a través de un conjunto de datos de calibración para permitir la generación de estructuras orientadas hacia propiedades específicas, que luego se pueden calibrar aún más utilizando varios algoritmos. Muchos ejemplos de esto implican el uso de representaciones de cadenas o gráficos. Sin embargo, se encuentran dificultades con respecto a la validez química o las propiedades deseadas cuando éstas no se obtienen con éxito. Además, el hecho de confiar en conjuntos de datos limita el espacio de búsqueda e introduce sesgos potencialmente indeseables.

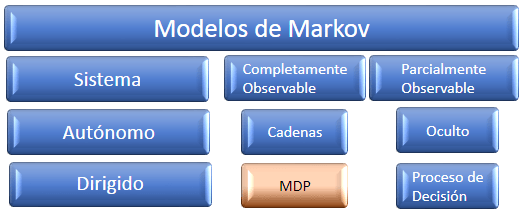
Un intento de mejora es utilizar el Proceso de Decisión de Markov (MDP) para garantizar la validez de las estructuras químicas y optimizar el MDP para lograr las propiedades deseadas a través del Q-learning profundo (un algoritmo de aprendizaje por refuerzo sin modelo para derivar el valor de una acción en un estado particular). En matemáticas, un MDP es un proceso de control estocástico de tiempo discreto (una función o señal, con valores dados en un conjunto elegido de tiempos en el dominio entero). Proporciona un marco matemático para modelar el proceso de toma de decisiones en situaciones donde los resultados son en parte aleatorios y en parte bajo el control de un tomador de decisiones. Los MDP son útiles para estudiar problemas de optimización resueltos mediante programación. Se utilizan en muchas disciplinas, incluyendo robótica, control automático, economía y fabricación. El MDP lleva el nombre del matemático ruso Andrej Andreevič Markov (1856 -1922).

Una ventaja particular de este modelo es que permite a los usuarios visualizar la preferencia de diferentes acciones: (a) visualizar el grado de preferencia para ciertas acciones (1 es la preferencia más alta, 0 la menos preferida); y (b) tomar medidas para maximizar la estimación cuantitativa de la similitud del fármaco con la molécula de partida.

Aunque todavía está en su infancia, el uso de la Inteligencia Artificial para explorar el espacio químico ya está mostrando una gran promesa. Nos proporciona un nuevo paradigma para explorar el espacio químico y una nueva forma de probar teorías e hipótesis. Aunque el empirismo no es tan preciso como la investigación experimental, los métodos basados en la computación seguirán siendo un área de investigación activa en el futuro previsible y ya formarán parte de cualquier grupo de investigación.

Hasta ahora hemos visto cómo la Inteligencia Artificial puede ayudar a descubrir nuevos productos químicos más rápidamente mediante la explotación de algoritmos generativos para buscar en el espacio químico. Aunque este es uno de los casos de uso más destacables, también hay otros. La Inteligencia Artificial se está aplicando a muchos otros problemas en química, incluyendo:

  1. Trabajo automatizado en laboratorio. Las técnicas de aprendizaje automático se pueden utilizar para acelerar los flujos de trabajo de síntesis. Un enfoque utiliza laboratorios autónomos para automatizar las tareas rutinarias, optimizar el gasto de recursos y ahorrar tiempo. Un ejemplo relativamente nuevo pero notable es el uso de la plataforma robótica Ada para automatizar la síntesis, el procesamiento y la caracterización de materiales. Las herramientas de Ada se desarrollan para proporcionar predicciones y modelos para automatizar procesos repetitivos, utilizando tecnologías de aprendizaje automático e inteligencia artificial para recopilar, comprender y procesar datos, de modo que los recursos puedan dedicarse a actividades de mayor valor agregado. Ada es básicamente un laboratorio que descubre y desarrolla nuevos materiales orgánicos de película delgada sin supervisión humana. Su productividad está haciendo que la mayoría de los recién graduados se sientan incómodos. Todo el ciclo de fabricación de película delgada, desde la mezcla de precursores químicos, pasando por la deposición y el recocido térmico, hasta la caracterización eléctrica y óptica final, toma solo veinte minutos. Una ayuda adicional es el uso de un robot químico móvil que puede operar herramientas y realizar mediciones en 688 experimentos durante ocho días..
  1. Predicción de reacciones químicas. Los modelos de clasificación se pueden usar para predecir el tipo de reacción que ocurrirá, o simplificar el problema y predecir si ocurrirá una determinada reacción química..
  2. Minería de datos químicos. La química, como muchas otras disciplinas, tiene una extensa literatura científica para el estudio de tendencias y correlaciones. Un ejemplo notable es la minería de datos de las grandes cantidades de información proporcionada por el Proyecto Genoma Humano para identificar tendencias en los datos genómicos..
  3. Finalmente, aunque la nueva tendencia basada en datos se está desarrollando rápidamente y ha tenido un gran impacto, también implica muchos desafíos nuevos, incluida la brecha entre la computación y el experimento. Aunque los métodos computacionales tienen como objetivo ayudar a lograr los objetivos del experimento, los resultados de los primeros no siempre son transferibles a los segundos. Por ejemplo, cuando se utiliza el aprendizaje automático para encontrar moléculas candidatas, debemos tener en cuenta que las moléculas rara vez son únicas en sus vías sintéticas, y a menudo es difícil saber si una reacción química inexplorada funcionará en la práctica. Incluso si funciona, hay problemas con el rendimiento, la pureza y el aislamiento del compuesto en estudio.
  4. La brecha entre el trabajo computacional y experimental se hace aún mayor, ya que los métodos computacionales utilizan métricas que no siempre son transferibles a este último, como la Electrodinámica Cuántica (QED), que describe todos los fenómenos que involucran partículas cargadas que interactúan por medio de la fuerza electromagnética, por lo que su verificación experimental puede no ser factible. También existe la necesidad de una mejor base de datos. Sin embargo, surge el problema de la falta de puntos de referencia. Dado que todo el espacio químico es infinito, se espera tener una muestra suficientemente grande que pueda ayudar en la generalización posterior. Sin embargo, la mayoría de las bases de datos actuales están diseñadas para diferentes propósitos y, a menudo, utilizan diferentes formatos de archivo. Algunos de ellos no tienen procedimientos de validación para las presentaciones o no están diseñados para tareas de IA. También hay que decir que la mayoría de las bases de datos disponibles tienen un alcance limitado de datos químicos: sólo contienen ciertos tipos de moléculas. Además, la mayoría de las tareas que implican el uso de IA para predicciones químicas no tienen plataformas de referencia hacienda que la comparación entre muchos estudios diferentes resulte impracticable.

Una de las principales razones del éxito de AlphaFold, que, como ya se ha visto, es un programa de IA desarrollado por DeepMind (Alphabet / Google) para predecir la estructura 3D de las proteínas, radica en el hecho de que ha proporcionado todo lo anterior como parte de la evaluación crítica de la predicción de la estructura de las proteínas, es decir, la inferencia de una estructura 3D de proteínas a partir de su secuencia de aminoácidos.  por ejemplo, la predicción de su estructura secundaria y terciaria a partir de su estructura primaria. Esta evaluación demuestra la necesidad de esfuerzos organizados para racionalizar, simplificar y mejorar otras tareas relacionadas con la predicción química.

En conclusión, a medida que continuamos avanzando en la era digital, nuevos algoritmos y hardware más poderoso continuarán levantando el velo sobre problemas previamente intratables. La integración de la Inteligencia Artificial en el descubrimiento químico todavía está en su infancia, pero ya es un lugar común escuchar el término «descubrimiento basado en datos». }

Muchas empresas, ya sean gigantes farmacéuticos o nuevas empresas recién fundadas, han adoptado muchas de las tecnologías anteriores y han aportado una mayor automatización, eficiencia y reproducibilidad a la química. La Inteligencia Artificial nos permite llevar a cabo la ciencia a una escala sin precedentes y en los últimos años esto ha generado muchas iniciativas y atraído fondos que continuarán llevándonos más lejos en una era de descubrimiento científico autónomo. (2. continuará).


* Copresidente del Consejo Asesor Honoris Causa. El Profesor Giancarlo Elia Valori es un eminente economista y empresario italiano. Posee prestigiosas distinciones académicas y órdenes nacionales. Ha dado conferencias sobre asuntos internacionales y economía en las principales universidades del mundo, como la Universidad de Pekín, la Universidad Hebrea de Jerusalén y la Universidad Yeshiva de Nueva York. Actualmente preside el «International World Group», es también presidente honorario de Huawei Italia, asesor económico del gigante chino HNA Group y miembro de la Junta de Ayan-Holding. En 1992 fue nombrado Oficial de la Legión de Honor de la República Francesa, con esta motivación: “Un hombre que puede ver a través de las fronteras para entender el mundo” y en 2002 recibió el título de “Honorable” de la Academia de Ciencias del Instituto de Francia.


Traducido al español por el Equipo de la SAEEG con expresa autorización del autor. Prohibida su reproducción. 

©2023-saeeg®
INTELIGENCIA ARTIFICIAL Y AVANCES EN QUÍMICA (I)

Giancarlo Elia Valori*

tommyvideo en Pixabay

Con el advenimiento de la tecnología de Inteligencia Artificial en el campo de la química, los métodos tradicionales basados en experimentos y modelos físicos se están complementando gradualmente con paradigmas de aprendizaje automático basados en datos. Cada vez se desarrollan más representaciones de datos para el procesamiento informático, que se adaptan constantemente a modelos estadísticos que son principalmente generativos.

Aunque la ingeniería, las finanzas y los negocios se beneficiarán enormemente de los nuevos algoritmos, las ventajas no provienen solo de los algoritmos. La computación a gran escala ha sido una parte integral de las herramientas de la ciencia física durante décadas, y algunos avances recientes en Inteligencia Artificial han comenzado a cambiar la forma en que se realizan los descubrimientos científicos.

Existe un gran entusiasmo por los logros destacados en ciencias físicas, como el uso del aprendizaje automático para reproducir imágenes de agujeros negros o la contribución de AlphaFold, un programa de IA desarrollado por DeepMind (Alphabet / Google) para predecir la estructura 3D de las proteínas.

Uno de los principales objetivos de la química es comprender la materia, sus propiedades y los cambios que puede sufrir. Por ejemplo, cuando buscamos nuevos superconductores, vacunas o cualquier otro material con las propiedades que deseamos, recurrimos a la química.

Tradicionalmente pensamos que la química se practica en laboratorios con tubos de ensayo, matraces Erlenmeyer (generalmente recipientes graduados con un fondo plano, un cuerpo cónico y un cuello cilíndrico) y quemadores de gas. En los últimos años, sin embargo, también se ha beneficiado de los desarrollos en los campos de la informática y la mecánica cuántica, los cuales se hicieron importantes a mediados del siglo XX. Las primeras aplicaciones incluyeron el uso de computadoras para resolver cálculos de fórmulas basadas en la física, o simulaciones de sistemas químicos (aunque lejos de ser perfectos) combinando química teórica con programación informática. Ese trabajo finalmente se convirtió en el subgrupo ahora conocido como química computacional. Este campo comenzó a desarrollarse en la década de 1970 y los Premios Nobel de química fueron otorgados en 1998 al británico John A. Pople (por su desarrollo de métodos computacionales en química cuántica: el método Pariser-Parr-Pople), y en 2013 al austriaco Martin Karplus, al sudafricano Michael Levitt y a Arieh Warshel de Israel por el desarrollo de modelos multiescala para sistemas químicos complejos.

De hecho, aunque la química computacional ha ganado cada vez más reconocimiento en las últimas décadas, es mucho menos importante que los experimentos de laboratorio, que son la piedra angular del descubrimiento.

Sin embargo, teniendo en cuenta los avances actuales en Inteligencia Artificial, las tecnologías centradas en los datos y las cantidades cada vez mayores de datos, podemos estar presenciando un cambio en el que los métodos computacionales se utilizan no solo para ayudar a los experimentos de laboratorio, sino también para guiarlos y orientarlos

De ahí que ¿cómo logra la Inteligencia Artificial esta transformación? Un desarrollo particular es la aplicación del aprendizaje automático al descubrimiento de materiales y al diseño molecular, que son dos problemas fundamentales en química.

En los métodos tradicionales, el diseño de moléculas se divide aproximadamente en varias etapas. Es importante tener en cuenta que cada etapa puede tomar varios años y muchos recursos, y el éxito no está garantizado de ninguna manera. Las fases del descubrimiento químico son las siguientes: síntesis, aislamiento y pruebas, validación, aprobación, comercialización y comercialización.

La fase de descubrimiento se basa en marcos teóricos desarrollados durante siglos para guiar y orientar el diseño molecular. Sin embargo, al buscar materiales «útiles» (por ejemplo, gel de petróleo [vaselina], politetrafluoroetileno [teflón], penicilina, etc.), debemos recordar que muchos de ellos provienen de compuestos que se encuentran comúnmente en la naturaleza. Además, la utilidad de estos compuestos a menudo se descubre solo en una etapa posterior. Por el contrario, la investigación dirigida es una tarea que consume más tiempo y recursos (e incluso en este caso puede ser necesario utilizar compuestos «útiles» conocidos como punto de partida). Solo para darle una idea, ¡el espacio químico farmacológicamente activo (es decir, el número de moléculas) se ha estimado en 1060! Incluso antes de las fases de prueba y dimensionamiento, la investigación manual en un espacio de este tipo puede llevar mucho tiempo y consumir muchos recursos. Por lo tanto, ¿cómo puede la Inteligencia Artificial entrar en esto y acelerar el descubrimiento de la sustancia química?

En primer lugar, el aprendizaje automático mejora los métodos existentes de simulación de entornos químicos. Ya hemos mencionado que la química computacional permite evitar parcialmente los experimentos de laboratorio. Sin embargo, los cálculos de química computacional que simulan procesos mecánicos cuánticos son pobres tanto en términos de costo computacional como de precisión de simulaciones químicas.

Un problema central en química computacional es resolver la ecuación de 1926 del físico Erwin Schrödinger (1887-1961). El científico describió el comportamiento de un electrón que orbita el núcleo como el de una onda estacionaria. Por lo tanto, propuso una ecuación, llamada ecuación de onda, con la que representar la onda asociada con el electrón. En este sentido, la ecuación es para moléculas complejas, es decir, dadas las posiciones de un conjunto de núcleos y el número total de electrones, se deben calcular las propiedades de interés. Las soluciones exactas solo son posibles para sistemas de un solo electrón, mientras que para otros sistemas debemos confiar en aproximaciones «suficientemente buenas». Además, muchos métodos comunes para aproximar la ecuación de Schrödinger se escalan exponencialmente, lo que dificulta la resolución de soluciones forzadas. Con el tiempo, se han desarrollado muchos métodos para acelerar los cálculos sin sacrificar demasiado la precisión. Sin embargo, incluso algunos métodos «más baratos» pueden causar cuellos de botella computacionales.

Una forma en que la Inteligencia Artificial puede acelerar estos cálculos es combinándolos con el aprendizaje automático. Otro enfoque ignora completamente el modelado de procesos físicos mediante el mapeo directo de representaciones moleculares en las propiedades deseadas. Ambos métodos permiten a los químicos examinar de manera más eficiente las bases de datos para diversas propiedades, como la carga nuclear, la energía de ionización, etc.

Si bien los cálculos más rápidos son una mejora, no resuelven el problema de que todavía estamos confinados a compuestos conocidos, que representan solo una pequeña parte del espacio químico activo. Todavía tenemos que especificar manualmente las moléculas que queremos analizar. ¿Cómo podemos revertir este paradigma y diseñar un algoritmo para buscar en el espacio químico y encontrar sustancias candidatas adecuadas? La respuesta puede estar en la aplicación de modelos generativos a problemas de descubrimiento molecular.

Pero antes de abordar este tema, vale la pena hablar sobre cómo representar numéricamente las estructuras químicas (y qué se puede usar para el modelado generativo). Muchas representaciones se han desarrollado en las últimas décadas, la mayoría de las cuales caen en una de las siguientes cuatro categorías: cadenas, archivos de texto, matrices y gráficos.

Las estructuras químicas obviamente se pueden representar como matrices. Las representaciones matriciales de moléculas se utilizaron inicialmente para facilitar las búsquedas en bases de datos químicas. A principios de la década de 2000, sin embargo, se introdujo una nueva representación matricial llamada Extended Connectivity Fingerprint (ECFP). En informática, la huella digital o huella digital de un archivo es una secuencia alfanumérica o cadena de bits de una longitud fija que identifica ese archivo con las características intrínsecas del propio archivo. El ECFP fue diseñado específicamente para capturar características relacionadas con la actividad molecular y a menudo se considera una de las primeras caracterizaciones en los intentos de predecir las propiedades moleculares.

La información de la estructura química también se puede transferir a un archivo de texto, una salida común de los cálculos de química cuántica. Estos archivos de texto pueden contener información muy rica, pero generalmente no son muy útiles como entrada para modelos de aprendizaje automático. Por otro lado, la representación de cadenas codifica mucha información en su sintaxis. Esto los hace particularmente adecuados para el modelado generativo, al igual que la generación de texto. Finalmente, la representación basada en gráficos es más natural. No solo nos permite codificar propiedades específicas del átomo en las incrustaciones de nodos, sino que también captura enlaces químicos en las incrustaciones de borde. Además, cuando se combina con el intercambio de mensajes, la representación basada en gráficos nos permite interpretar (y configurar) la influencia de un nodo en otro nodo por sus vecinos, lo que refleja la forma en que los átomos en una estructura química interactúan entre sí. Estas propiedades hacen que las representaciones basadas en gráficos sean el tipo preferido de representación de entrada para modelos de aprendizaje profundo. (1. continuará)

* Copresidente del Consejo Asesor Honoris Causa. El Profesor Giancarlo Elia Valori es un eminente economista y empresario italiano. Posee prestigiosas distinciones académicas y órdenes nacionales. Ha dado conferencias sobre asuntos internacionales y economía en las principales universidades del mundo, como la Universidad de Pekín, la Universidad Hebrea de Jerusalén y la Universidad Yeshiva de Nueva York. Actualmente preside el «International World Group», es también presidente honorario de Huawei Italia, asesor económico del gigante chino HNA Group y miembro de la Junta de Ayan-Holding. En 1992 fue nombrado Oficial de la Legión de Honor de la República Francesa, con esta motivación: “Un hombre que puede ver a través de las fronteras para entender el mundo” y en 2002 recibió el título de “Honorable” de la Academia de Ciencias del Instituto de Francia.


Traducido al español por el Equipo de la SAEEG con expresa autorización del autor. Prohibida su reproducción.

©2023-saeeg®